
跨越“次元壁”:智象元一梅涛提出智能体化世界模型新路径
自达特茅斯会议首次提出人工智能的概念,已将近70年。如今,大语言模型正在加速推开数字 AI的大门,但人工智能通往物理世界的道路依旧阻塞难行。在刚刚结束的2026世界顶尖科学家论坛上,加拿大工程院外籍院士、智象元一(HiDream)创始人兼CEO梅涛发表演讲,提出智能体化的全模态世界模型(Agentic World Models)的理念,为数字 AI向物理 AI的跨越提供一条全新的技术路径。
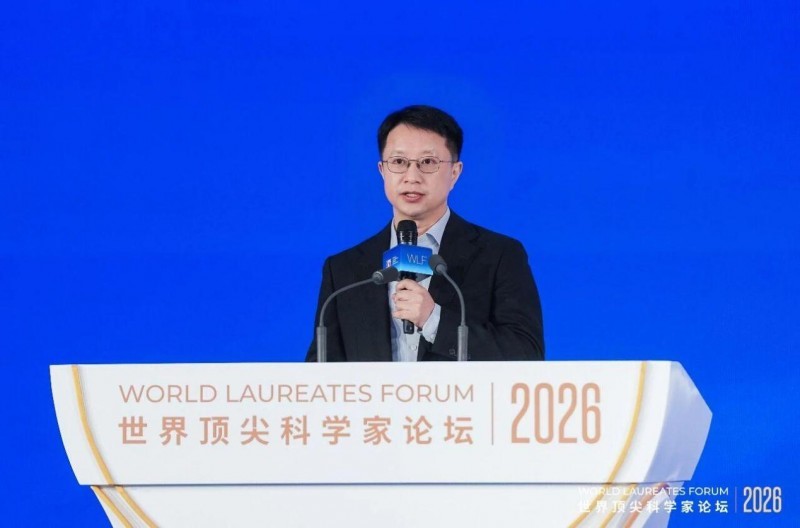
Digital AI加速狂飙,Physical AI仍在小步慢跑
根据OpenRoute统计,截至今年10月,中国周Token调用量达到93万亿,是美国的4.16倍,连续26周位居全球第一。另一方面,模型迭代也在持续加速:2023年大模型大致以12个月为周期迭代,此后周期不断压缩,六个月,三个月,一个月……如今已按周推进。这些数字背后,是AI正从"工具"快速演变为像水、电一样的新型社会基础设施。
但这种进化并不均衡,AI在数字世界与物理世界的能力,正在形成显著分化。Digital AI的发展极为迅猛,在文本对话、逻辑推理与多模态生成几个维度上,其能力已逼近人类顶尖水准:OpenAI于10月一次性公布377项数学成果,DeepMind独立攻克9个厄多斯问题,其中两个难题已悬置56年。相比之下,Physical AI的进展滞后很多。其
规模化应用面临三项共性挑战:物理世界理解与预测不足,真实交互数据与规模化学习受限,闭环执行的泛化与可靠性不足。
如何跨越这道横亘于Digital AI与Physical AI之间的鸿沟,正是下一代人工智能必须回答的时代命题。而世界模型,作为行业新的共识,被寄予了厚望。
三条路径通往世界模型,但各有局限
世界模型目前尚无一个被所有人公认的统一定义。2018年,两位AI学者David Ha与Jürgen Schmidhuber提出理解框架:世界模型 = 观察世界(V)+ 预测世界(M)+ 在内部世界中学习行动(C),这后来成为学术界与产业界共同沿用的叙事底座。
经过数年发展,当前行业对于通往世界模型之路,已分化出大致三条技术路线。第一条为大语言模型路线,以语言符号为核心载体,主攻自然理解、逻辑推理与结构化知识的高密度压缩,主要代表是ChatGPT。今年9月GPT-6 Astra横空出世,让语言大模型通往世界模型的路径第一次变得可行。
第二条为多模态模型路线,以图文音视频等多模态信息为核心,聚焦理解感知与内容生成能力,代表模型有腾讯混元HY-World、阿里Happy Oyster和智象HiDream-O1系列。
第三条为具身大模型路线,强调物理世界感知、闭环交互与可执行动作生成,代表模型包含Gemini Robotics、英伟达GR00T等。GR00T已从仿真训练走向真实机器人部署,Gemini Robotics则实现了对完整人形机器人的控制。
三条路径都有其自洽的逻辑,但任一模式单独推至极致,都会撞上结构性壁垒:LLM无法依托离散文本符号建立物理世界的感知;视频模型能够实现二维空间的像素拟合,但难以完成在三维世界的因果推演;具身智能虽然直面真实物理交互,看似具备行动闭环的天然入口,但如何拥有通用能力,行业仍未找到有效手段。什么是世界模型的最终形态,当下可能没人能给出标准答案。但有一点明确:其必然是一种跨模态、跨任务、跨场景、跨硬件的存在,依赖任何单一模态或载体都会有局限性。
智能体化的世界模型:一条跨越断层的解法
梅涛认为,三条技术路径终将汇聚为全模态模型:因为真实世界是包含空间、时间、物理与因果的连续系统,因此需要统一处理文字、图像、视频、空间、动作、位姿、力触与传感器等模态。而这一步仅仅解决了"表达",世界模型还需要实现"推演"和"重建":通过Agentic Learning引入目标驱动、主动探索、多步规划与外部反馈,使智能体不再只做一次预测,而是借助世界模型模拟、比较并选择多种可能的未来,再以真实行动验证;最后由世界模型自身将感知转化为状态估计,在时空里保持对象持久性,并学习动作条件下的世界演化规律。由此,梅涛以全模态、Agentic Learning与世界模型三个核心要素为基础,提出"智能体化的世界模型(AWM)"。
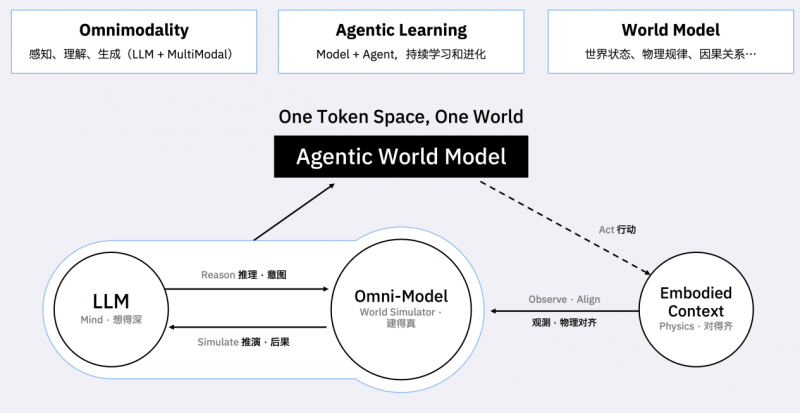
面对一项任务,AWM不仅能推演某一行动可能带来的结果,还能围绕目标主动拆解任务、比较多种行动方案,并在执行过程中根据环境反馈调整后续步骤——模型不只是提供一次预测,而是参与从规划、行动到反馈调整的持续过程。
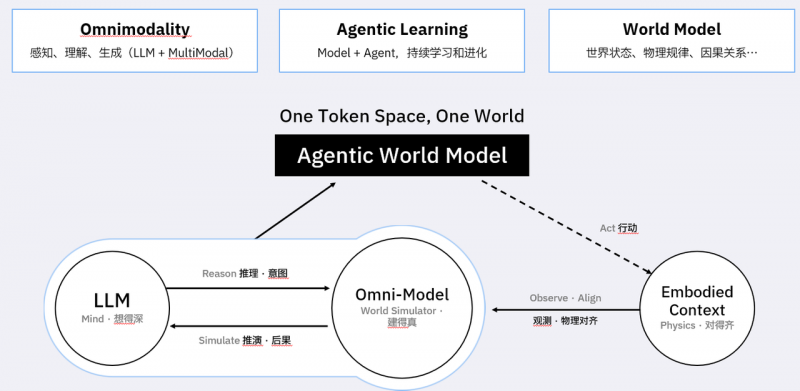
AWM由三个部分组成:LLM作为智能体的决策大脑,负责理解意图、生成推理、制定任务规划;Omni-Model基于LLM的意图模拟物理世界运行,推演行动后果并预测下一步动作;Embodied Context负责执行具身行动,同时将真实环境观测数据回传,用于校准世界模型。三者串成一条从看懂世界到在世界中行动的通路,并形成两个闭环:一是LLM与Omni-Model之间的"知识与逻辑推理闭环",二是Omni-Model与物理世界之间的"物理对齐闭环"。两个闭环循环往复,共同构建起最终实现"One Token Space, One World"——在同一Token空间中实现思维世界与物理世界的统一。
以"杯子倒地"为例:传统视频模型只是基于大数据做像素拟合,输入"一个杯子倒在地上",会按概率最大化把"杯子"和"倒"随机组合,输出一张看似符合描述的画面。而在AWM模式下,模型会先"过一遍脑子"——像人预演一样,把杯子和倒地动作构建成可推演的数字世界:杯子是铁还是塑料?地面是水泥还是木板?倒下角度多少?重力下几秒落地?接触不同材质反弹多高、撞击声如何?等问题都要经过严格计算,等一切与计算结果吻合,再由模型渲染画面完成输出。
沿着AWM的思路,智象自研出原生全模态架构UiT,并演化出图像模型HiDream-O1-Image、视频模型HiDream-O1-Video、交互世界模型HiDream-O1-World、具身世界模型HiDream-O1-Embodied四大模型,分别探索空间关系理解、符合物理规律的时序生成、世界状态的连续变化以及感知、行动与反馈的协同,勾勒出智能体化原生全模态世界模型的初步雏形。
需要承认的是,通往世界模型的技术路线仍在进化演变,对技术走势的判断远比大语言模型早期更复杂。但回望AI发展的每一次范式更替,深度学习三起三落、CNN被冷落十年后靠AlexNet翻盘,很多伟大的构想恰恰诞生于路线未定、方向未明之时。通往世界模型没有现成路线可循,唯一可以确定的是,任何方向都不是等出来的,而是走出来的。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”