从快手业务实践到全球开源共建,Apache Auron毕业成为Apache顶级项目



当下,数据规模持续增长与算力成本压力并行,大数据计算引擎的性能优化走向执行引擎级的重构,向量化执行与原生执行成为突破性能瓶颈的重要方向。
10月14日,国际权威开源软件基金会Apache 官方博客正式发布Apache Auron™ 毕业消息,宣布Apache Auron从孵化器毕业,成为Apache顶级项目(Top-Level Project,TLP)。此前,Apache Auron的毕业提案已于2026年9月在Apache孵化器项目管理委员会(IPMC)投票中顺利通过,并随后获得Apache软件基金会董事会批准。至此,Auron正式从孵化阶段走向独立自治,进入Apache顶级项目治理体系。
作为源于快手大规模数据计算的生产实践,Auron由快手公司立项、研发,于2025年8月捐赠给Apache软件基金会孵化器。从进入孵化器到顺利毕业,Auron仅用时13个月。
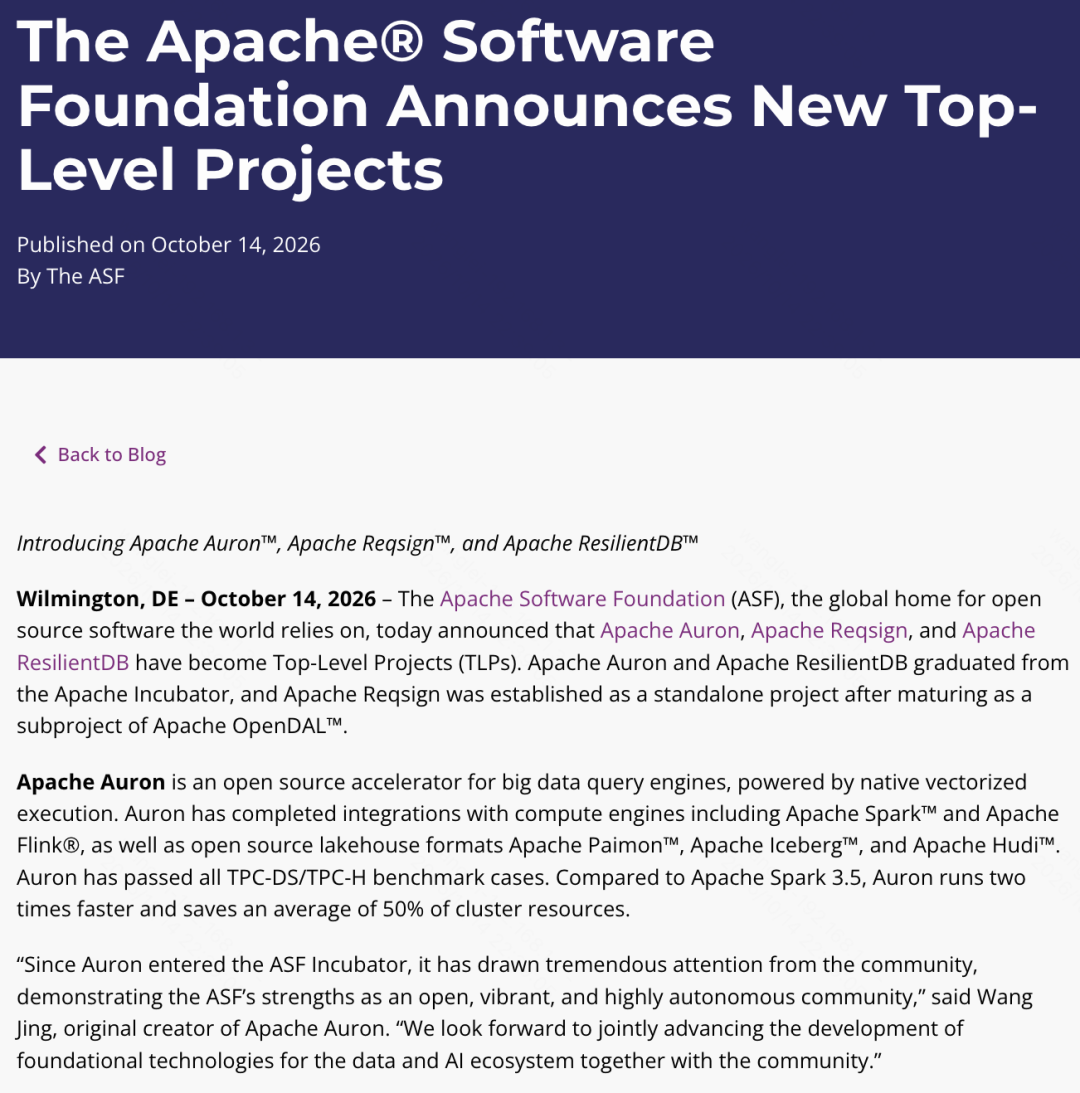
Apache Auron是一个面向大数据引擎的原生向量化执行加速器,当前聚焦于加速 Apache Spark 的查询处理。它结合Apache Arrow-Data Fusion的原生计算能力与 Spark 的分布式计算框架,将Spark优化后的物理计划转换为等价的原生执行计划,交由基于Rust实现的Native Engine执行,在提升性能的同时降低资源开销。目前,Auron已在数十家企业的生产环境中完成部署,覆盖多个行业的业务场景,并在实际线上运行中取得显著的降本增效收益。
快手高级副总裁、研发线负责人郭亮表示,Auron项目在快手公司立项、研发,并取得了大规模的落地实践和非常可观的大数据成本优化收益,快手一直秉承开放、共创的技术开源精神,并将Auron捐赠给ASF,也期待能与社区一起推动Data + AI生态基建技术发展。
突破向量化执行技术,让大数据计算引擎跑出「原生」速度
从一项团队内部的技术探索,到由全球开发者共同建设的开源项目,Auron的起点源于快手日常生产中大规模数据处理的真实挑战。随着数据规模持续增长,基于JVM的行式处理逐渐成为Spark的CPU性能瓶颈。快手给出的解法,是不改动上层业务SQL,而为Spark替换一层更高效的执行引擎。
在项目孵化期间,Auron社区保持高速迭代与稳定发布,累计发布三个版本;过去6个月,master分支共合入179个commit,贡献者来自20多家不同公司。毕业之际,社区已有18位Committer依毕业决议全部转为项目管理委员会(PMC)成员,并与4位孵化导师共同组成22人的PMC,形成了多元化、跨组织的治理格局。
正是由于汇聚了不同开源项目、拥有丰富Apache社区经验的PPMC成员与Committer的团队,Auron顺利突破技术瓶颈,为大数据计算领域贡献了重要发展成果。此前,传统大数据计算引擎采用逐条处理的方式:每处理一条数据,都要完整走一遍固定流程,数据量越大,CPU延迟就越明显。为突破这一瓶颈,Auron采用向量化执行按批(Batch)处理数据,从而最大限度发挥SIMD指令优势,充分利用CPU的并行计算能力。
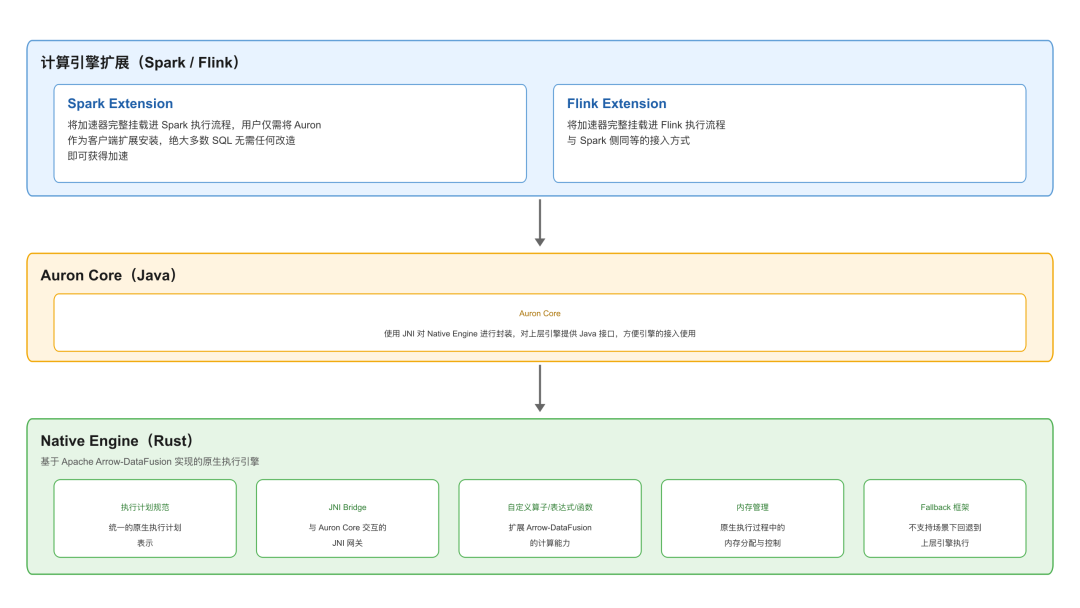
从具体技术路径来看,Auron的核心架构主要分为四大部分:Spark Extension ,能实现将加速器完整挂载进Spark执行流程,用户仅需将Auron作为客户端扩展安装,绝大多数SQL无需任何改造即可获得加速;Flink Extension ,支持加速器完整挂载进Flink执行流程;Auron Core ,使用JNI对Native Engine 进行封装,对上层引擎提供Java接口,方便接入使用;Native Engine (Rust),以基于Apache Arrow-Data Fusion 实现的原生执行引擎,提供包含执行计划规范、JNI网关、自定义算子/表达式/函数,以及内存管理、Fallback框架等基础能力。
基于此,Auron在多维度上呈现出优秀的加速性能。原生执行、性能可预期,核心引擎由Rust实现,规避JVM开销,具备稳定、确定性的执行性能;向量化计算基于Apache Arrow 列式格式,利用SIMD指令批量处理数据,最大化计算吞吐;完善的Fallback机制使未实现的算子和表达式可自动回退到Spark原生执行,UDF/UDTF、UDAF等自定义函数同样支持,保证“只要Spark能跑,Auron就能跑”;可插拔架构面向多引擎扩展,当前深度集成Apache Spark ,并基于Data Fusion 良好的可扩展性,扩展支持Apache Flink等其他大数据计算引擎。
在周边生态与生产夯实方面,Auron适配开源湖仓格式Apache Paimon™、Apache Iceberg™ 和Apache Hudi ,开源Shuffle Service 框架Apache Celeborn™ 和Apache Uniffle ,以及HDFS、S3等存储系统;同时具备多级内存管理、紧凑化Shuffle格式、自适应执行策略。
ASF Member、Apache Auron 孵化导师,LinkedIn Principal Staff Software Engineer秦江杰表示,良好的版本兼容性和易用性一直是Auron非常突出的特点,也让Native Execution 的性能收益能够更容易地落地到实际生产环境。
实现规模化落地验证,计算运行提速2倍+、节省约50%资源
技术能力的价值,最终需要可量化的实际应用运行结果来检验。当前,Apache Auron已全部通过TPC-DS/TPC-H基准用例;相比Apache Spark3.5,在TPC-DS基准下Auron运行速度提升2倍以上,同时节省约50%的计算资源。在大规模生产环境中,Auron已在超过EB级(Exabytes)数据规模下验证运行,覆盖JSON解析、UDF/UDTF等复杂生产场景,并解决了多项稳定性与数据一致性问题。
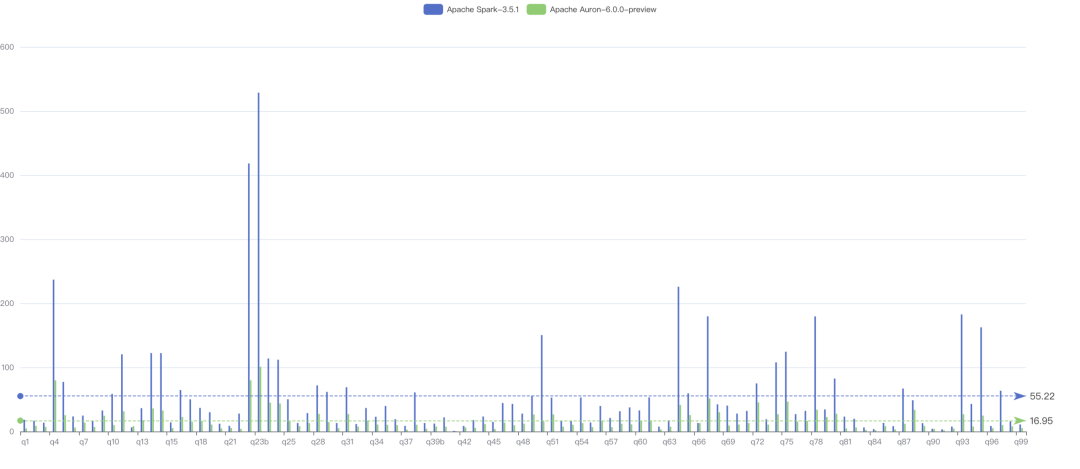
除标准基准测试外,真实生产环境中的规模化部署情况,同样是衡量项目成熟度的重要依据。目前,Auron已在快手、滴滴、58同城、携程、OPPO、LinkedIn、汽车之家等数十家公司的生产环境中部署落地,并在线上场景中取得了显著的降本增效收益。
58同城数据架构部负责人余意介绍,58同城在大数据计算场景中持续关注并实践Auron,已经落地任务2.5W+,提效占比65%,平均提效45%以上;Auron通过原生向量化执行,在保持较低接入门槛的前提下,为现有大数据平台带来了更高的计算效率和更好的资源利用率。
滴滴大数据计算引擎负责人张润林表示,在大规模数据处理场景中,计算效率、运行稳定性与资源成本始终是关注的核心问题;Auron以原生向量化执行技术为大数据计算加速,为企业提升计算效率、释放存量资源价值提供了新的选择。
从孵化走向毕业,Apache Auron 也将进入更广阔的生态场景。Apache Auron PMC Chair王磊表示,Auron将不断拓展生态版图,一方面,持续适配并完善Apache Spark 、Apache Flink 等主流大数据计算引擎,让更多引擎的查询负载都能获得原生执行的加速能力;另一方面,基于cuDF打造Auron on GPU能力,把向量化执行从CPU延伸到GPU,让Auron适应AI与GPU算力时代对高性能数据计算的全新需求。
具体来看,Auron将继续围绕四大方向深耕:拓展应用生态,完善Auron在Apache Flink 流和批场景的支持,以及对Lance/Vortex等新型存储格式的适配;增加对异构硬件的支持,从CPU向量化计算扩展到对GPU和FPGA等异构硬件的支持,进一步提升大数据引擎算子性能;贴近生产场景,持续提升各类算子与函数的覆盖率,以及解决性能、稳定性、数据一致性问题;做大社区、做强生态,携手更多企业与开发者以Committer/Contributor身份加入,共建开放、多元、可持续的社区。
从快手内部的工程实践,到Apache软件基金会的顶级项目,Auron在一年多的孵化周期内完成了身份转换。对快手而言,Auron的毕业不只是一次开源成果的交付。作为项目的发起方,快手在大规模数据处理场景中积累的工程经验,正通过Apache社区这一开放平台向更广泛的开发者与企业开放。未来,快手将持续参与Data + AI生态共建,把在大规模数据处理等领域的实践经验与社区共享,与各界伙伴一道,推动数据智能行业技术的创新突破。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”